限时 7 折优惠!领取优惠
HappyHorse 1.1 · 联合音频 + 7 语口型同步

HappyHorse 1.1 多语口型同步说话片段

7 语联合音频与嘴部运动——文案、首帧,或最多 9 张参考图。

镜头必须说话时,跑 HappyHorse 1.1。用七种语言之一导对白,画面与声音同一遍完成,并用最多九张参考静帧锁住角色。花费前先选 720p 或 1080p 与时长——门槛 75 积分。

  • 七种语言口型同步对白
  • 联合音视频遍——不是仅静音动态栈
  • 文案、一张起始帧,或最多 9 张参考图
  • 3–15 秒片段,720p 或 1080p(此模型无 4K)
  • 720p 25 积分/秒 · 1080p 30 · 门槛 75
HappyHorse 1.1 产品主视觉——青铜马头、琥珀声波与奶油色字样
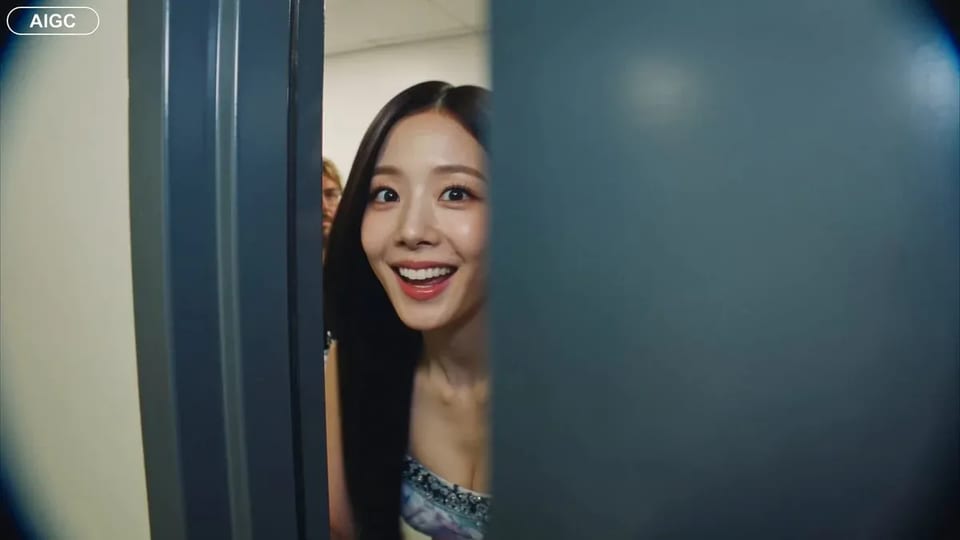
Handheld backstage idol vlog sample

CAMERA: Handheld DV 16mm camcorder aesthetic, first-person/selfie POV. CHASE always holds the camera. Natural hand shake, imperfect framing, delayed autofocus, clumsy zooms, occasional face cropping. The camcorder is never visible. LOOK: Soft vintage DV tape quality with slight blur, subtle tape noise, mild highlight bloom, flickering auto-exposure, muted contrast, natural skin tones. STYLE: Bright, playful K-pop idol vlog. Genuine smiles, eye contact, candid energy, quick handheld shots with backstage excitement. CHARACTER: CHASE, Korean female idol in her 20s. Long straight black hair, dewy skin, elegant Korean features, coral lips, large eyes, slim curvy figure. Wearing a stylish stage outfit with subtle glam makeup and sparkly earrings. SETTING: Backstage hallway of a music show studio with dressing room doors, CHASE's name tag on one door, snack table, overhead PA speaker, and blurred staff passing by. SEQUENCE: 1. Selfie: peeks into the hallway. "Hey guys, we're backstage!" 2. Whip pan down the corridor. "This hallway is so long!" 3. Stops at her dressing room, points at her name tag. "That's me!" 4. Close-up of the name tag as she taps it. Ambient audio only. 5. Quick outfit check with a spin near a mirror. "How do I look?" 6. At the snack table, grabs a snack. "Don't mind if I do." 7. Mid-bite, PA announcement interrupts. She laughs: "Wait—" 8. Selfie ending: hears the countdown, waves, makes a hand heart, then runs toward the stage. "That's my cue—see you after the stage!"

CAMERA: Handheld DV 16mm camcorder aesthetic, first-person/selfie POV. CHASE always holds the camera. Natural hand shake, imperfect framing, delayed autofocus, clumsy zooms, occasional face cropping. The camcorder is never visible. LOOK: Soft vintage DV tape quality with slight blur, subtle tape noise, mild highlight bloom, flickering auto-exposure, muted contrast, natural skin tones. STYLE: Bright, playful K-pop idol vlog. Genuine smiles, eye contact, candid energy, quick handheld shots with backstage excitement. CHARACTER: CHASE, Korean female idol in her 20s. Long straight black hair, dewy skin, elegant Korean features, coral lips, large eyes, slim curvy figure. Wearing a stylish stage outfit with subtle glam makeup and sparkly earrings. SETTING: Backstage hallway of a music show studio with dressing room doors, CHASE's name tag on one door, snack table, overhead PA speaker, and blurred staff passing by. SEQUENCE: 1. Selfie: peeks into the hallway. "Hey guys, we're backstage!" 2. Whip pan down the corridor. "This hallway is so long!" 3. Stops at her dressing room, points at her name tag. "That's me!" 4. Close-up of the name tag as she taps it. Ambient audio only. 5. Quick outfit check with a spin near a mirror. "How do I look?" 6. At the snack table, grabs a snack. "Don't mind if I do." 7. Mid-bite, PA announcement interrupts. She laughs: "Wait—" 8. Selfie ending: hears the countdown, waves, makes a hand heart, then runs toward the stage. "That's my cue—see you after the stage!"
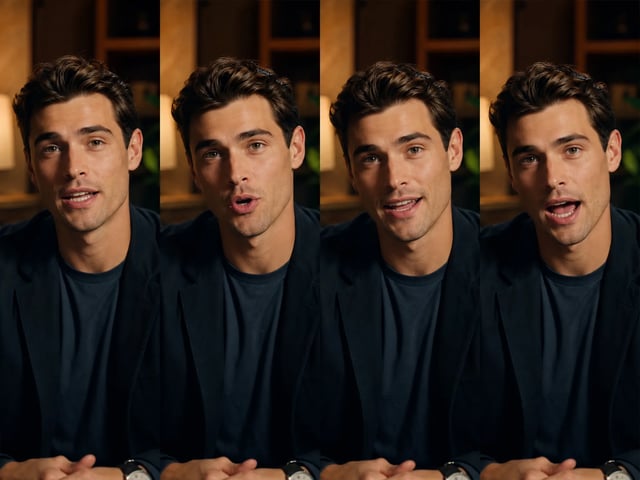
HappyHorse 1.1:联合音频与口型同步的说话视频

为对白主导片段而建——不是仅静音动态栈。

可选文生视频、首帧起步,或最多九张图的参考模式以保持角色一致。片段 3–15 秒,720p(25 积分/秒)或 1080p(30 积分/秒),门槛 75 积分。此模型无 4K 路径。商用交付需付费套餐。

选 HappyHorse 做说话片段的四个理由

每一行都是花费决策:语言、声音遍、角色锁定或格式成本——不是泛泛利益清单。

用七种语言之一导台本

在提示词里写出对白并点名口语语言。口型同步覆盖英语、普通话、粤语、日语、韩语、德语与法语——就是这一组,不是开放世界列表。适合代言切、配音讲解或本地化广告必须看起来在说话,而不是冻嘴唇上硬字幕。需要这七种之外的语言时换模型,或规划后期配音,别指望嘴型跟上。

出镜主播说话,连续口型提示口型同步对白

画面与声音同一联合遍排队

Alibaba 的 ATH 设计在出帧同时合成音频——对白、氛围与拟音对准同一镜头,而不是总要事后配乐的静音渲染。声音随画面落地时,片段可能已带分轨与口型同步,但没有单独音频开关,所以别把每条文件当保证音轨。交客户前先听结果。

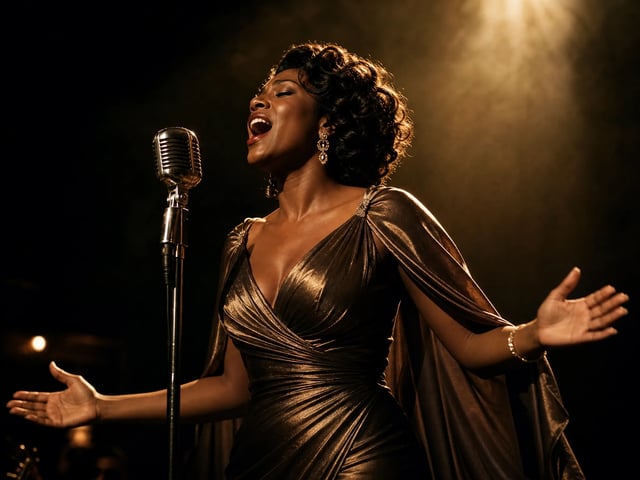
表演中的歌手,暗示联合音视频生成

用最多九张参考静帧锁角色

参考模式最多九张图——不是源视频。在提示词里指向 [Image 1]…[Image 9] 以固定脸、服装、产品包装或色板跨镜头。短序列里同一出镜人不必微调就靠这个。图生视频不同:需要一张起始帧,画幅由该帧派生,无单独画幅控制。别上传运动板指望视频到视频;那条路径在 Seedance 2 与 Omni Flash 编辑。

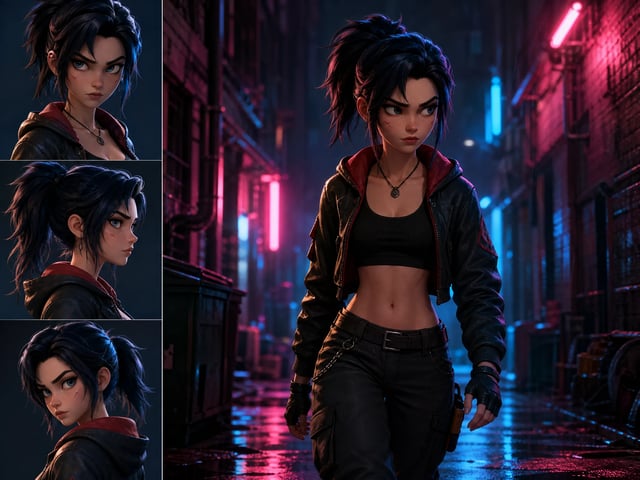
同一角色经参考静帧保持一致进入新场景

花费前先选时长与分辨率

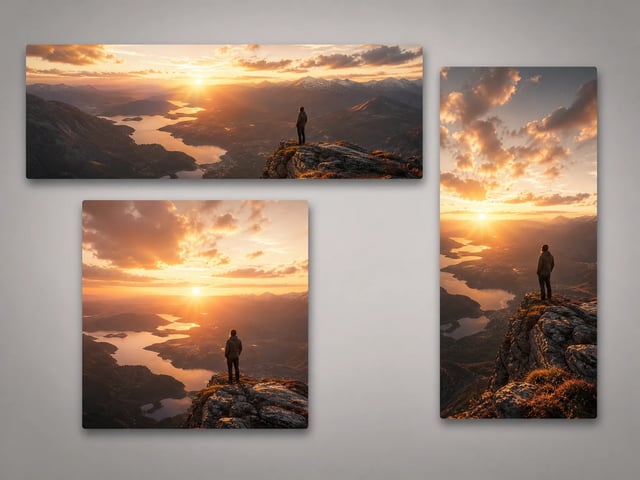
时长为 3 到 15 秒的整数。分辨率仅 720p 或 1080p——HappyHorse 1.1 无 4K。文案与参考模式暴露较宽画幅选择;帧模式继承起始图画幅。积分按秒:720p 25,1080p 30,门槛 75,因此 3 秒 × 720p 是最便宜合法片段。排队前在生成器读实时费用。

同一场景展示宽、方与竖画幅
说话路径

从台本到说话片段的四个决定

每一步都改变成本、角色或语言——不是泛泛上传教程。

  1. 1
    选文案、首帧或参考静帧

    选文案、首帧或参考静帧

    从文字场景起步、动画一张必需起始图,或附最多九张参考静帧锁角色。参考模式仅图像条件——有源片段驱动运动时跳过它。

  2. 2
    写清动作与台词

    写清动作与台词

    把发生什么与说什么写进提示词。需要英语、普通话、粤语、日语、韩语、德语或法语口型同步时点名语言。参考模式标出 [Image 1]…[Image 9],让脸与产品落在你想要的位置。

  3. 3
    设 3–15 秒与 720p 或 1080p

    设 3–15 秒与 720p 或 1080p

    让时长匹配要说完的台词。4K 留给别的模型。花费前确认积分报价——720p 25/秒,1080p 30/秒,从不低于 75。

  4. 4
    渲染、听,再迭代台词

    渲染、听,再迭代台词

    排队镜头,检查嘴型时机与返回音频。改对白、换参考,或同一角色重跑下一镜,不必离开生成器。

货架核对

何时说话视频胜过静音动态模型

只比输入、分辨率上限、时长与积分形态——不做质量排名。目标是说话时高亮留在 HappyHorse 1.1。

当前 HappyHorse 1.1 说话 / 口型同步路径 用 HappyHorse 说这段需求
Seedance 2 运动 + 4K + 源视频 打开 Seedance 2
Veo 3.1 固定片段 Google 路径 打开 Veo 3.1
何时选 角色必须说话;多语嘴型 需要 4K 或源视频条件 要 Google Veo 固定时长到 4K
输入模式 文案 · 首帧 · 最多 9 参考图(无源视频) 文案 · 图 · 视频参考(视频到视频) 文案 · 图(文生 / 图生)
分辨率上限 仅 720p 或 1080p 最高 4K(另有 480p–1080p) 720p / 1080p / 4K
时长控制 用户整数 3–15 秒 用户时长 × 分辨率定价 固定时长片段(约 8 秒类)
积分形态 720p 25/秒 · 1080p 30/秒 · 门槛 75 按秒 × 分辨率(4K 最高) 按分辨率档固定按条
语音 / 音频焦点 联合音视频 + 7 语口型同步 运动优先;此处非说话/口型焦点 不是多语口型同步模型

说话任务

需要嘴型跟上对白的工作

围绕语音、语言市场与角色连贯的人设——不是静音 B-roll。

  • 创始人出镜宣告

    用口型同步对白把产品线直接说给镜头,十秒声明不必为发布切开一整天棚。

  • 本地化制片

    同一讲解用普通话、日语或德语交付,嘴型匹配各语言,而不是单条英语硬字幕。

  • 付费社媒买手

    竖屏 9:16 切按市场换对白,同时用参考静帧锁住同一出镜人。

  • 课程作者

    把短课台本变成有旁白的说话头像段,大纲变了可重跑。

  • 产品营销

    动画包装静帧并配上口述卖点,演示自解释,不必另开 VO 场。

  • 角色短片导演

    用 [Image 1]–[Image 9] 参考在三拍里保持同一角色,对白场景脸不漂。

生成前关于 HappyHorse 1.1 的问题

HappyHorse 1.1 能口型同步哪些语言?

在 SupaImagine 上,HappyHorse 1.1 为七种语言的口型同步对白配置:英语、普通话、粤语、日语、韩语、德语与法语。选与台词匹配的语言,让嘴部运动与音频对齐。

每个文件都会有可听语音与嘴部运动吗?

模型设计为与画面一起合成声音,并让嘴型匹配对白,因此许多镜头带回分轨与口型同步。发布前仍预览每次导出——把联合音频当设计目标,而不是静音回退模式。

文案、首帧与九图参考模式有何不同?

文案模式从提示词构建说话片段。首帧模式用一张静帧锁定开场外观。参考模式最多九张图,在你导台词时保持角色与服装连贯。

75 积分门槛与按秒费率如何运作?

计费为 720p 每秒 25 积分、1080p 每秒 30。最便宜合法运行为 720p 3 秒(75 积分),也是门槛。更长或 1080p 由此上浮。

HappyHorse 1.1 到 4K 吗?

不到。此模型仅暴露 720p 与 1080p。需要 4K 交付时,在这里完成构图再视频放大,或选能 4K 的模型做最终遍。

可用哪些片段时长?

3 到 15 秒。花费前让时长与对白匹配,使台词落在窗口内。

何时 HappyHorse 比通用文生视频赛道更合适?

多语说话头、角色台词或口型同步 UGC 是任务时开 HappyHorse 1.1。只需静音或非对白电影感动态时用通用运动模型。

付费套餐上的 HappyHorse 片段可商用吗?

在付费 SupaImagine 套餐与站点条款下可以。人才、标志与你不拥有的类音乐底需自行清理。

为角色必须说的下句台词排队

多语口型同步、联合音视频镜头,以及最多九张参考静帧——720p–1080p,3–15 秒,门槛 75 积分。